រៀបរៀងដោយអ្នកនិពន្ធ: Christiane Rousseau។
តាំងពីការចាប់ផ្ដើមដំបូងបំផុតរបស់ Google, Google បានក្លាយជាឧបករណ៍ស្រាវជ្រាវដំបូងបំផុត ។ ការតម្រៀបទិន្នន័យទាំងនេះតាម algorithm (The PageRank algorithm) ជាមួយនឹងទិន្នន័យជាច្រើនទំព័រនៅលើ World-Wide-Web ហើយការស្រាវជ្រាវជាច្រើន បញ្ចប់ទៅដោយលទ្ធផលជាច្រើនលានលទ្ធផល។ ប្រសិនបើការរាវរកមិនបានត្រឹមត្រូវតាមលំដាប់លំដោយ នោះការស្វែងរករបស់យើងត្រូវបរាជ័យ និងគ្មាននរណាម្នាក់អាចស្រាវជ្រាវរកឃើញទិន្នន័យដែលខ្លួនចង់បាននៅក្នុងចំណោមទិន្នន័យរាប់សិបលានដែលមាននៅលើ world-wide-Web។
តើ PageRank algorithm ធ្វើការរបៀបម៉េច?
យើងនឹងពន្យល់អំពីបញ្ហាទាំងអស់នេះ។ ប៉ុន្តែមុនដំបូង យើងបង្ហាញការស្រាវជ្រាវមួយនៅលើGoogle នៅថ្ងៃទី ៤ ខែ មិថុនា ឆ្នាំ ២០១០ ដែលទទួលបាន ១៦,៣០០,០០០ លទ្ធផល សម្រាប់ Klein project ដែលនេះគ្រាន់តែជាការចាប់ផ្ដើមលើកដំបូងតែប៉ុណ្ណោះរបស់គម្រោងនេះ។
ជាដំបូង យើងអាចភ្ជាប់ចូលទៅកាន់ៈ
http://www.mathunion.org/icmi/other-activities/klein-project/introduction/
ហើយក៏អាចចូលទៅកាន់ៈ
http://www.kleinproject.org/
វេបសាយចម្បងគេនៅលើ Internet គឺ URL (URL= Uniform Resource Location) ដែលបង្ហាញនៅលើវេបសាយសហគមន៍គណិតវិទ្យាអន្តរជាតិ ( The International Mathematical Union ) : http://www.mathunion.org។ ពីព្រោះសហគមន៍គណិតវិទ្យាអន្តរជាតិ គឺជាចំណុចសំខាន់នៅលើវេបសាយ ពេលដែលយើងបង្កើតការស្រាវជ្រាវ “ International Mathematical Union ” ម្យ៉ាងវិញទៀតវាធ្វើការ ទំនាក់ទំនងទៅលើផ្នែកសំខាន់ៗជាច្រើននៃទំព័រវេបសាយ ។ ហើយទំព័រមួយក្នុងចំណោមទំព័រទាំងនោះគឺ
http://www.mathunion.org/icmi/other-activities/klein-project/introduction/
ចាប់ពីពេលនេះ បន្តទៅមុខក្នុងកំឡុងពេល ២ ទៅ ៣ខែ ឬ ២ ទៅ ៣ឆ្នាំ យើងអាចជឿជាក់ថាទំព័រវេបសាយ http://www.kleinproject.org/ នឹងបង្ហាញដំបូងបង្អស់សម្រាប់ការស្រាវជ្រាវ klein project ។
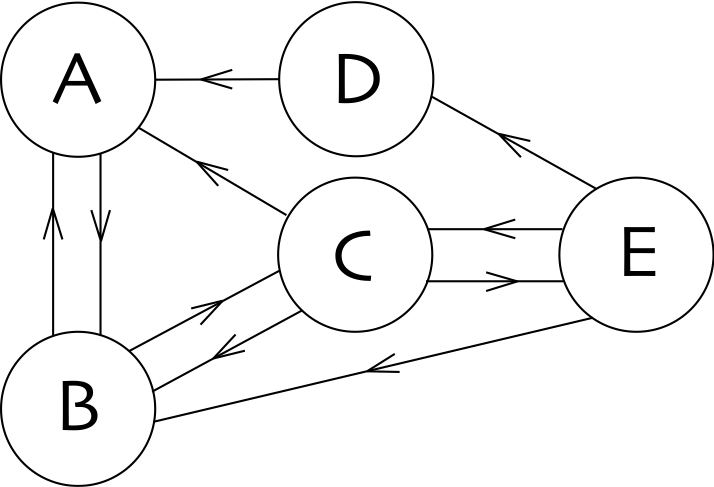
ដើម្បីពន្យល់អំពី algorithm យើងយកគំរូតាមក្រាបទិសដៅដែលបានបង្ហាញខាងលើ ។ យើងកំណត់យកផ្ទាំងមូលៗតំណាងអោយទំព័រដែលស្ថិតនៅលើវេបសាយ និងសញ្ញាបញ្ជាក់ទិសដៅតំណាងអោយការភ្ជាប់ទំនាក់ទំនងពីទំព័រមួយទៅទំព័រមួយ ។ ដូច្នេះទំព័រវេបសាយនីមួយៗមានទំនាក់ទំនងគ្នាជាមួយទំព័រដ៏ទៃទៀត នៅលើប្រព័ន្ធវេបសាយទាំងនេះ ។ ក៏ប៉ុន្តែភាគច្រើនទំព័រដែលយើងត្រូវការតាម algorithm នឹងបង្ហាញ ទំព័រណាដែលល្អ ហើយមានសារៈសំខាន់បំផុត ។
ឧទាហរណ៍ៈ
ពួកយើងក្រឡេកមើលវេបសាយសាមញ្ញមួយ ដែលបានបង្ហាញនូវខាងលើនេះដែលមានឈ្មោះសម្រាប់ ៥ទំព័រគឺ  ,
 ,
 ,
 និង
 ។ នៅលើវេបសាយមួយ វាអាចភ្ជាប់ជាមួយទំព័រផ្សេងទៀតបាន ២ រឺ៣ទំព័រ ។ ប្រសិនបើយើងបើកទំព័រ មួយ នោះយើងមានតែមួយទំព័រគត់ដែលអាចបង្ហាញបាន នោះគឺទំព័រ ភ្លាមនោះដែរ ប្រសិនបើយើងបើកទំព័រ យើងនឹងបានទំព័របីផ្សេងទៀត ដែលមានទំនាក់ទំនងជាមួយវា ហើយយើងអាចផ្លាស់ប្ដូរទៅទំព័រផ្សេងទៀតបានដោយងាយ ដូចជាទៅទំព័រ រឺ រឺ ជាដើម ។ ដូចនេះយើងត្រូវចងចាំថា យ៉ាងហោចណាស់ក៏មាន មួយទំព័រយ៉ាងតិចនៅពេលដែលយើងបានបើកចូលទំព័រណាមួយហើយនោះ ។
យើងចាប់ផ្ដើមសាកល្បងលេងល្បែងនេះ ជ្រើសរើសយកមួយទំព័រដោយចៃដន្យណាមួយក៏បាន បន្ទាប់មក បន្តអនុវត្តការភ្ជាប់ទៅទំនាក់ទំនាក់ចំពោះទំព័រដ៏ទៃទៀត ។ ឧទាហរណ៍ៈ ប្រសិនបើយើងចាប់ផ្ដើមនៅលើទំព័រ នោះបន្ទាប់មកយើងអាចធ្វើដំណើរបន្តទៅទំព័រ រឺ ផ្សេងទៀត ជាមួយប្រូបាប  សម្រាប់ករណីនីមួយៗ ។ ប៉ុន្តែប្រសិនបើយើង ចាប់ផ្ដើមនៅលើទំព័រ នោះយើងអាចធ្វើដំណើរទៅទំព័រ តែមួយគត់ ជាមួយនឹងប្រូបាបស្មើ
 ។ តាមរយៈល្បែងនេះ
តើយើងនឹងបានទំព័រណា បន្ទាប់ពីយើងធ្វើដំណើរបាន  ជំហាន?
យើងសង្ខេបទិន្នន័យទាំងនេះ ក្នុងម៉ាទ្រីស  ដែលយកធាតុនៃម៉ាទ្រីសតាមជួរដេក និង ជួរឈរ ជាតម្លៃប្រូបាបនៃករណីនីមួយៗ ។ ទិន្នន័យដែលយើងទទួលបានគឺ
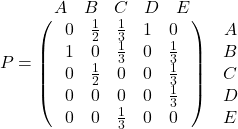
យើងសម្គាល់ឃើញថា ផលបូកតម្លៃតាមជួរឈរនីមួយៗមានតម្លៃស្មើនឹង ១ ហើយធាតុទាំងអស់នោះមានតម្លៃធំជាង ឬ ស្មើនឹង ០ ។ ម៉ាទ្រីសនេះមានពីរលក្ខណៈសំខាន់គឺ ម៉ាទ្រីសនីមួយៗ គឺជាម៉ាទ្រីសនៃ Markov chain process ដែលគេអាចហៅថា Markov transition matrix។ វាតែងតែមានតម្លៃស្មើនឹង ១ ជានិច្ច វាដូចគ្នាទៅនឹងតម្លៃ eigenvalue ដែលតម្លៃនេះមានចំពោះវ៉ិចទ័រ eigenvector ជាមួយតម្លៃ eigenvalue ស្មើនឹង១ ហើយធាតុនីមួយៗរបស់ម៉ាទ្រីសមានតម្លៃនៅចន្លោះពី  និងផលបូកជួរឈរមានតម្លៃស្មើនឹង ១ ។ ប៉ុន្តែ មុននឹងរំលឹកឡើងវិញនូវនិយមន័យរបស់តម្លៃ eigenvalue និងវ៉ិចទ័រ eigenvector យើងធ្វើការស្រាវជ្រាវពី ប្រយោជន៍នៃម៉ាទ្រីសដែលបានបង្ហាញតាមរយៈក្រាហ្វនៃវេបសាយ ។
យើងគិតពិចារណាទៅលើអត្រាបម្រែបម្រួលចៃដន្យនៃ  ជាមួយនឹងតម្លៃនៅក្នុងគេហទំព័រទាំងនេះ
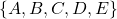 ដែលមាន
 ទំព័រ (ពេលនេះ
 ) ។ តំណាងអោយទំព័រដែលយើងបន្ទាប់ពី ជំហាន ។ យើងកំណត់
 ជាធាតុនៃម៉ាទ្រីស ដែល
 ជាជួរដេក ហើយ
 ជាជួរឈរ , ម្យ៉ាងទៀត គឺជា ប្រូបាបមានលក្ខខណ្ឌ ដែលទំព័រទី គឺជាតួទី
 ហើយ ទំព័រទី ជាតួទី ។
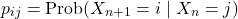
ចាំថា ប្រូបាបនេះ គឺមានករណីអាចស្មើនឹង ! ដែលយើងអាចនិយាយបានថា Markov chain process ពុំមានការចងចាំនៅក្នុងអតីតកាលឡើយ ។ វាមិនពិបាកក្នុងការគូសបន្ទាត់តំណាងប្រូបាបបន្ទាប់ពីធ្វើបានពីរជំហាននោះទេ ដែលយើងអាចសង្ខេបវាបាននៅក្នុងម៉ាទ្រីស  ។
យើងបង្ហាញទ្រឹស្ដីបទប្រូបាប ដែលមានប្រយោជន៍មួយចំនួនៈ
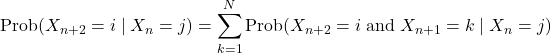
និយមន័យប្រូបាបមានលក្ខខណ្ឌគឺ
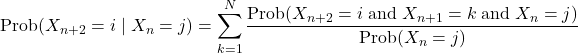
យើងប្រើវិធីដែលធ្លាប់ប្រើកន្លងមកៈ គុណ ចែក នឹងចំនួនតែមួយៈ
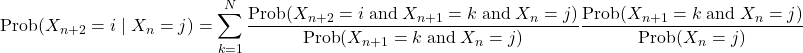
ផលចែកដំបូងស្មើនឹងៈ
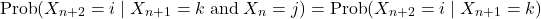
ចាប់តាំងពី Markov chain process មិនអាចចងចាំនៃជំហានពីមុន ដូចនេះ
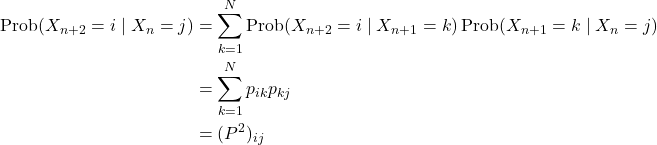
នៅក្នុងឧទាហរណ៍របស់យើងគឺ
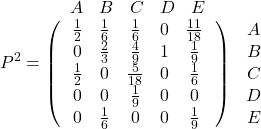
គិតសាឡើងវិញពីគំនិតទាំងនេះ វាច្បាស់ណាស់ថាធាតុ  នៃម៉ាទ្រីស
 ដែលបានរៀបរាប់ ពីប្រូបាប
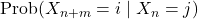 តួយ៉ាងដូចជា
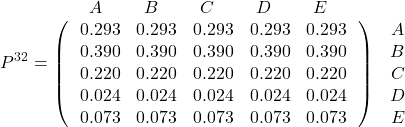
គ្រប់ជួរឈរនៃ  គឺដូចគ្នាបេះបិទ ប្រសិនបើយើងធ្វើការជ្រើសរើសផ្នែកទសភាគ៣ខ្ទង់ ហើយគ្រប់ ជួរឈរទាំងអស់នៃ
 ពេលដែល
 ។ បើសិនជាយើងជ្រើសរើសតម្លៃដែលត្រឹមត្រូវខ្ពស់ជាងនេះ យើងសង្កេតឃើញតម្លៃនេះមិនប្រែប្រួលទេ ទោះបី ធំជាង ៣២ ក៏ដោយ ។ ដូចនេះបន្ទាប់ពី ជំហានមក តម្លៃដែលយើងត្រូវយកគឺវាធំល្មមគ្រប់គ្រាន់ ហើយតម្លៃប្រូបាបនៃទំនាក់ទំនងទំព័រនីមួយៗមិនជាប់គ្នាទៅនឹងទំព័រ ដែលយើងបានចាប់ផ្ដើមដំបូងនោះទេ ។
យើងពិចារណាទៅលើវ៉ិចទ័រ 
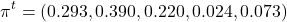
គឺជាវ៉ិចទ័រតំណាងអោយជួរឈរ ហើយ  គឺវ៉ិចទ័រតំណាងអោយជួរដេក ។ វាងាយស្រួលនឹងពិនិត្យឃើញថា
 ។ បើសិនជាយើងគិតលើ កូអរដោនេទី នៃវ៉ិចទ័រ គឺវាដូចគ្នានឹងតម្លៃប្រូបាបនៃទំព័រទី នៅខណៈ ដូច្នេះ គឺជាតម្លៃប្រូបាបនៃទំព័រដែលបានរៀបចំហើយនៅខណៈ ហើយវាក៏ជាប្រូបាបនៅខណៈ ផងដែរ ។ គេអាចហៅ វ៉ិចទ័រ ថាជា តម្លៃរបាយមិនប្រែប្រួល ។ តម្លៃរបាយមិនប្រែប្រួលនេះ គឺវារៀបតាមលំដាប់នៃទំព័រទាំងនោះ ។ ឧទាហរណ៍ៈ យើងតម្រៀបទំព័រតាមលំដាប់
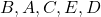 ហើយយើងបញ្ជាក់ថាទំព័រ ជាទំព័រសំខាន់ជាងគេបំផុត ។
ករណីទូទៅៈ
ករណីទូទៅអាចក្លាយជាការអនុវត្តយ៉ាងពិតប្រាកដនៅក្នុងឧទាហរណ៍របស់យើង ។ យើងតាងគេហទំព័រទាំងនោះដោយ ក្រាហ្វទិសដៅមួយ ដែលមាន ជាជួរឈរ ក្នុងចំនួន ទំព័រនៃគេហទំព័រនេះ ហើយគែម ទិសដៅតំណាងអោយការតភ្ជាប់គ្នាពីទំព័រមួយទៅទំព័រមួយ ។ យើងអាចសង្ខេបទិន្នន័យទាំងនេះនៅក្នុងម៉ាទ្រីសលំដាប់  នៃម៉ាទ្រីស ជាមួយនឹងជួរឈរ ជាផ្នែកទី នៃទំព័រដែលចាកចេញ និង ជួរដេក ជាផ្នែកទី នៃទំព័រដែលត្រឡប់មកដល់ ។ នៅក្នុងឧទាហរណ៍យើង យើងបានរកឃើញវ៉ិចទ័រ បំពេញដោយ ។ វ៉ិចទ័រនេះជាវ៉ិចទ័រ eigenvector ដែលមានតម្លៃ eigenvalue ស្មើនឹង ១ ។ ពួកយើងរំលឹកឡើងវិញនូវនិយមន័យ eigenvector និង eigenvalue ៖
និយមន័យៈ គេអោយ ជាម៉ាទ្រីសលំដាប់ ។  គឺជាតម្លៃ eigenvalue នៃម៉ាទ្រីស ប្រសិនបើ
 មិនមែនជាវ៉ិចទ័រសូន្យ ដែល
 នោះគេបាន
 ។ ហើយវ៉ិចទ័រ គេហៅថាវ៉ិចទ័រ eigenvector នៃម៉ាទ្រីស ។
យើងអាចរំលឹកពីរបៀបរកតម្លៃ eigenvalue និងវ៉ិចទ័រ eigenvector ផងដែរៈ
អំណះអំណាងៈ គេអោយ គឺជាម៉ាទ្រីសលំដាប់ ។ តម្លៃ eigenvalue នៃម៉ាទ្រីស គឺជារឹសនៃកន្សោមពហុធា 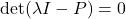 ដែល
 ជាវ៉ិចទ័រឯកតាលំដាប់ ហើយវ៉ិចទ័រ eigenvector នៃតម្លៃ eigenvalue
 គឺជាចម្លើយមិនសូន្យ នៃប្រព័ន្ធសមីការលីនេអ៊ែរ
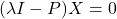 ។
តាមទ្រឹស្ដីបទ Frobenius ធានាថា សម្រាប់ម៉ាទ្រីសដែលជាប់ទាក់ទងនឹងក្រាហ្វវេបសាយ យើងតែងតែរកឃើញការដោះស្រាយមិនប្រែប្រួលជានិច្ច។
ទ្រឹស្ដីបទៈ (Frobenius theorem) យើងពិនិត្យមើលម៉ាទ្រីស Markov លំដាប់ ក្លាយទៅជាម៉ាទ្រីស  (ដែល
 ហើយគ្រប់ , និងផលបូកនៃតម្លៃតាមជួរដេកនីមួយៗ គឺស្មើនឹង ដែល
 )។ ហើយបន្ទាប់មក
 គឺជាមួយតម្លៃ eigenvalue នៃម៉ាទ្រីស
- តម្លៃ eigenvalue នីមួយៗ នៃម៉ាទ្រីស ,

- តម្លៃ eigenvalue នៃវ៉ិចទ័រ eigenvector ស្មើនឹង ហើយគ្រប់កូអរដោនេនីមួយៗ មានតម្លៃធំជាងរឺស្មើនឹង ០ ។ ដោយមិនគិតពីឱកាសដែលបាត់បង់ យើងអាចគិតស្មានទុកជាមុនថា ផលបូកលេខនៃកូអរដោនេទាំងនោះស្មើនឹង ។
ពេលនេះយើងស្គាល់អំពីផលវិជ្ជមានរបស់ទ្រឹស្ដីបទនេះ។ គោលបំណងរបស់យើង យើងនឹងបង្កើតសម្មតិកម្មមួយដែលថា ម៉ាទ្រីស មានវ៉ិចទ័រមូលដ្ឋាន eigenvector 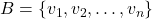 និងយើងគិតថា
 គឺជាវ៉ិចទ័រ នៃទ្រឹស្ដីបទ Frobenius។ សម្រាប់វ៉ិចទ័រ
 នីមួយៗត្រូវមានតម្លៃ
 ដែល
 ។ យើងយកវ៉ិចទ័រមិនសូន្យណាមួយនៃ ហើយ
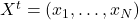 ដែល
 និង
 ។ យើងបំបែកធាតុ ក្នុង :

បច្ចេកទេសក្នុងការដោះស្រាយដែលយើងបានរំលងចោលនៅក្នុងចំណុចមុន វាអាចទាញបញ្ជាក់ថា  ។ ឥឡូវយើងចាប់ផ្ដើមគណនា

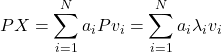
គឺជាវ៉ិចទ័រ eigenvector នៃតម្លៃ eigenvalue ។ ហើយបើសិនជាយើងពិនិត្យឡើងវិញ យើងទទួលបាន
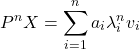
ប្រសិនបើតម្លៃ សម្រាប់  ដែល
 នោះ
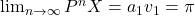
នេះបញ្ជាក់ថានឹងមានបញ្ហាអ្វីកើតឡើង ចំពោះឧទាហរណ៍របស់យើង!!
ទោះជាយ៉ាងណាក៏ដោយ ទ្រឹស្ដីបទមិនបានធានាថា ម៉ាទ្រីស នីមួយៗអាចបំពេញតម្រូវការតាមការប៉ាន់ស្មានរបស់ទ្រឹស្ដីបទឡើយ។ យើងនឹងរៀបរាប់អំពីបញ្ហាដែលអាចនឹងកើតមានឡើង និង វិធីទប់ស្កាត់ ។
បញ្ហាដែលអាចកើតមានឡើងៈ
- តម្លៃ eigenvalue ប្រហែលជាស្មើនឹងផលគុណរឹសនៃកន្សោមពហុធារបស់
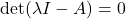
- ម៉ាទ្រីស ប្រហែលជាអាចមានតម្លៃ eigenvalue ផ្សេងទៀត មានតម្លៃធំជាង ជាមួយម៉ូឌុយឡូស្មើនឹង ។
តើត្រូវធ្វើដូចម្ដេចក្នុងករណីនេះ?
យើងប្រើអន្តរម៉ាទ្រីស Markov ដើម្បីបញ្ចៀសបញ្ហាទាំងឡាយដែលអាចកើតមាន ដែលគេអោយឈ្មោះម៉ាទ្រីស Markov តាមរយៈ
និយមន័យៈ អន្តរម៉ាទ្រីស Markov នេះមានភាពទៀងទាត់ប្រសិនបើ
- តម្លៃ eigenvalue គឺជារឹសធម្មតានៃផលគុណពហុធារបស់
- គ្រប់តម្លៃ eigenvalue ទាំងអស់នៃម៉ាទ្រីស ធំជាង ដែលមានម៉ូឌុយឡូតូចជាង ។
កត់សម្គាល់ថា ម៉ាទ្រីស ភាគច្រើនគឺមានភាពទៀងទាត់ណាស់ ។ ដូច្នេះ ប្រសិនបើមានម៉ាទ្រីសណាមិនប្រក្រតី យើងត្រូវរិះរកយុទ្ធសាស្ដ្រណាមួយដើម្បីបង្កើតអោយមានម៉ាទ្រីសដែលមានភាពទៀងទាត់មួយយ៉ាងតិច។
វិធីទប់ស្កាត់ៈ យើងពិចារណាទៅលើម៉ាទ្រីស  លំដាប់ ដែល
 ចំពោះគ្រប់ ចំនួនគត់
 យើងធ្វើការផ្លាស់ប្ដូរម៉ាទ្រីស នៃគេហទំព័រ ទៅជាម៉ាទ្រីសដូចខាងក្រោមៈ
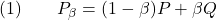
សម្រាប់តម្លៃ  តូចមួយ ដែល
 (តម្លៃ
 ធ្លាប់បានប្រើនៅក្នុង Google) បញ្ជាក់ថា ម៉ាទ្រីស
 នៅតែមានធាតុធំជាងរឺស្មើ ០ ហើយផលបូកធាតុនៃជួរឈរនីមួយៗ មានតម្លៃស្មើ ដែលវានៅតែជាអន្តរម៉ាទ្រីស Markov ។ តាមទ្រឹស្ដីបទ បញ្ជាក់ថាមានតម្លៃតូចមួយ ណាមួយដែលធ្វើអោយបញ្ហា ត្រូវកើតមានឋិតនៅនឹងថ្កល់មួយកន្លែង ។
ទ្រឹស្ដីបទៈ គេអោយ អន្តរម៉ាទ្រីស Markov នីមួយៗមានតម្លៃវិជ្ជមាន តូចមួយតាមដែលយើងចង់បាន ដូចនេះ ម៉ាទ្រីស គឺមិនប្រែប្រួល ។ អោយ ជាវ៉ិចទ័រ eigenvector ដែលមានតម្លៃ eigenvalue សម្រាប់ម៉ាទ្រីស ហើយធ្វើអោយផលបូកនៃកូអរដោនេមានតម្លៃស្មើ ។ សម្រាប់ម៉ាទ្រីស អោយវ៉ិចទ័រ មិនសូន្យ ដែល 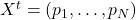 ជាមួយនឹង
 និង
 ហើយ
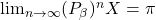 ។
ការភ្ជាប់ជាមួយនឹងទ្រឹស្ដីចំនុចថេរ Banach:
ការយកអត្ថបទខ្លីៗសំខាន់ៗចំពោះទ្រឹស្ដីបទចំណុចថេរ Banach ទ្រឹស្ដីបទខាងលើ អាចមានលក្ខខណ្ឌពិសេសសម្រាប់ការអនុវត្តនេះ ។ យើងអាចរំលងផ្នែកនេះប្រសិនបើអ្នកមិនបានអានអត្ថបទខ្លីៗដែលមានសារៈសំខាន់ៗដ៏ទៃទៀត ។
ទ្រឹស្ដីបទៈ អោយម៉ាទ្រីស ជាអន្តរម៉ាទ្រីស។ យើងគិតពិចារណា 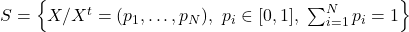 ជាមួយនឹងចម្ងាយគ្រប់គ្រាន់
 នៅចន្លោះចំណុចជាច្រើន (ចំណុចនេះអាស្រ័យនឹងម៉ាទ្រីស ) ។ នៅលើ
 យើងគិតថាលីនេអ៊ែរនៃ
 ចង្អុលបង្ហាញតាមរយៈ
 ។ ការធ្វើដំណើរការរបស់
 បានបង្រួមទៅជា ដែលមានតម្លៃ
![c\in[0,1[](https://blog.kleinproject.org/wp-content/ql-cache/quicklatex.com-4a99dda6f44f3692384b523daddba164_l3.png "Rendered by QuickLaTeX.com") ហើយដែល គ្រប់
 ,
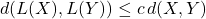 ។
មានវ៉ិចទ័រតែមួយគត់  ដែល

ម្យ៉ាងវិញទៀត តម្លៃ  យើងអាចចង្អុលបង្ហាញស្វ៊ីត
 តាមរយៈការណែនាំ ដែល
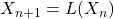 បន្ទាប់មក
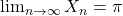 ។
និយមន័យចម្ងាយ  : និយមន័យចម្ងាយ គឺជាចំណុចប្រសព្វ និង រំលងទៅកន្លែងផ្សេងទៀត ។ យើងអាចបង្រួមវាបានដោយគ្រប់គ្រាន់សម្រាប់ការអាន សម្រាប់អ្នកដែលត្រូវការ ។ យើងកំណត់ដោយខ្លួនឯង ទៅតាមករណីដែលម៉ាទ្រីស គឺអាចមានលទ្ធភាពបញ្ចៀស ។ អោយ
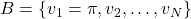 ដែលវាជា មូលដ្ឋាននៃវ៉ិចទ័រ eigenvector ។ វ៉ិចទ័រ អាចសរសេរជា វ៉ិចទ័រ
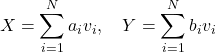
ដែល  បន្ទាប់មកយើងអាចទាញបានថាៈ
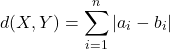
ជាមួយនឹងចម្ងាយនេះ គឺអាចបំពេញកន្លែងម៉ាទ្រីស ដូចជាគ្រប់ស្វ៊ីត Cauchy រួម ។
ទ្រឹស្ដីបទនេះ មិនអាចបំពេញគ្រប់គ្រាន់នៃ វ៉ិចទ័រ ប៉ុន្តែអោយវិធីមួយដើម្បីកសាងវាឡើងវិញ ដូចជាការកំណត់ស្វ៊ីត ។ យើងធ្លាប់ឃើញការបកស្រាយនៃការបង្រួមនៅក្នុងឧទាហរណ៍របស់យើង ។ តាមពិតជួរឈរទី នៃម៉ាទ្រីស គឺជាវ៉ិចទ័រ  ដែល
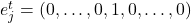 គឺជាវ៉ិចទ័រទី នៃ ការបែងចែកជាមូលដ្ឋានគ្រឹះកាណូនិច ។
នៅក្នុងឧទាហរណ៍របស់យើង យើងអាចរកឃើញវ៉ិចទ័រ តាមរយៈការដោះស្រាយប្រព័ន្ធ 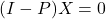 ជាមួយម៉ាទ្រីស
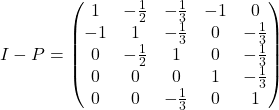
យើងស្វែងរកថា គ្រប់ដំណោះស្រាយគឺជាទម្រង់ 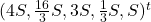 សម្រាប់
 ។ លទ្ធិផលនៃផលបូកកូអរដោនេ ស្មើ ដូចនេះ គឺ
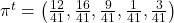
ការបែងចែកការគណនាដើម្បីអោយមានភាពងាយស្រួលៈ
យើងមានគំនិតត្រឹមត្រូវតិចតួចសម្រាប់ algorithm ។ ទោះជាយ៉ាងណាក៏ដោយ ការស្វែងរកវ៉ិចទ័រ ដូចជា វ៉ិចទ័រ eigenvector នៃតម្លៃ eigenvalue សម្រាប់ម៉ាទ្រីស ក្នុង (1) គឺវាមិនមែនជាការងារតូចតាចនោះទេ ពេលដែលម៉ាទ្រីសមានរាប់រយពាន់លានជួរឈរទាំងពីរ ទាំងការគណនាតាមម៉ាស៊ីន និង ការបង្ហាញស្មារតីបកស្រាយពីបញ្ហាពិតទាំងនេះ ។ ជាធម្មតា វិធីបំបាត់ Gauss គឺវាត្រូវការដើម្បីប្រែក្លាយ មេគុណអោយនៅតូច ។ ការដំណើរការ algorithm បង្កើតអោយមានការប្រើប្រាស់ លក្ខណៈ(២) (មើល[LM])។ ទាំងនេះអាចបង្កើតការតភ្ជាប់ជាមួយអត្ថបទទ្រឹស្ដីបទខ្លីៗរបស់ទ្រឹស្ដីបទចំណុចថេរ Banach ដែលនឹងពន្យល់ បានថា ទ្រឹស្ដីបទចំណុចថេរ Banach បានផ្ដល់អោយ algorithm អាចសាងសង់ចំណុចថេរមួយ ។
ជាការពិតណាស់ យើងអាចចាប់ផ្ដើមជាមួយ  ដូចខាងក្រោមៈ
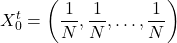
ហើយយើងត្រូវការការគណនា 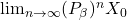 ជាធម្មតា
 ដែល នៅចន្លោះ ៥០ ទៅ ១០០ អោយតម្លៃប្រហែលដ៏ល្អមួយនៃ ។ ការណែនាំអោយយើងគណនា
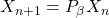 ការគណនារបៀបនេះពិតជាវែងឆ្ងាយខ្លាំងណាស់ ។ តាមពិត ដោយសារតែការបង្កើតម៉ាទ្រីស ក្នុង(១) មិនមានធាតុ
 ទេ។ នៅលើធាតុដ៏ទៃទៀត ភាគច្រើននៃធាតុទាំងនោះគឺ ។ ដូច្នេះ យើងត្រូវបំបែកការគណនាលេខដោយយកតែចំនុចសំខាន់ៗតែប៉ុណ្ណោះដែលៈ
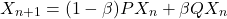
ពីព្រោះទម្រង់ពិសេសនៃ  គឺវាងាយស្រាយបំភ្លឺថា បើសិន គឺជាកត្តានៃផលបូកធាតុនីមួយៗស្មើនឹង ពេលដែល
 ។ ដូចនេះ វាគ្រប់គ្រាន់សម្រាប់ការគណនាស្វ៊ីតនេះ
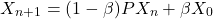
សន្និដ្ឋានៈ
យើងបានបង្ហាញជាសាធារណៈ នៃចំណែកមួយរបស់ Google’s PageRank algorithm។ អ្នកអាចមានបទពិសោធន៍គ្រប់គ្រាន់ ជាមួយនឹងគេហទំព័រធម្មតា និងការស្វែងរកល្បិចដើម្បីធ្វើអោយប្រសើរឡើងក្នុងការតម្រៀបទិន្នន័យនៃទំព័ររបស់អ្នក តាមរយៈការបន្ថែមការទំនាក់ទំនងទាំងខាងក្នុង និងខាងក្រៅ។ ការងារខ្លះ មានភាពឥតខ្ចោះ ដែលវារួមចំណែកក្នុងការអភិវឌ្ឍន៍ជាខ្លាំង ។ ពួកវាខ្លះកើតឡើង ដែលបានផ្លាស់ប្ដូរ “ neutral ” នៃម៉ាទ្រីស ក្នុង (១) តាមរយៈម៉ាទ្រីសជាច្រើនដែលមាននៅលើគេហទំព័រ ។ ការធានាផ្សេងទៀតបញ្ជាក់ថា ការតម្រៀបតម្លៃនេះ គឺមិនអាចអោយដឹងគ្រប់គ្រាន់ដែលជាហេតុនាំទៅរកនរណាម្នាក់អាចមានលទ្ធភាពធ្វើអោយប្រសើរឡើងចំពោះការរៀបចំគេហទំព័ររបស់ពួកគេ ។
សេចក្ដីសន្និដ្ឋានទូទៅៈ តើយើងបានធ្វើការអង្កេតលើអ្វើខ្លះ? ធម្មតាគំនិតវ័យឆ្លាតវានាំទៅរកការរកឃើញរបកគំហើញដ៏ធំមួយដែលគ្រប់គ្រាន់ក្នុងការស្វែងរកដោយម៉ាស៊ីន ហើយវាជាកំណើតនៃប្រភពពាណិជ្ជកម្ម។ ប្រសិនបើការគណនាដោយខ្លួនវាមានភាពមិនត្រឹមត្រូវ ដូច្នេះគំនិតដំបូងត្រូវការ “ធាតុ” នៃគណិតវិទ្យា ដែល អោយឈ្មោះថា ពីជគណិតលីនេអ៊ែរ និងទ្រឹស្ដីបទប្រូបាប ។ ទំនាក់ទំនងជាស្ដង់ដានៃទ្រឹស្ដីគណិតវិទ្យាក្នុងអង្កត់ទ្រូងពិសេសនៃម៉ាទ្រីស ដែលវាមានប្រសិទ្ធភាពនៅពេលដែលគេយកវាទៅប្រើនៅខាងក្រៅនៃបរិបទធម្មតារបស់ពួកគេមួយ។ យើងមានផ្នែកសំខាន់ផងដែរ ដែលរួមផ្សំគំនិតនៅក្នុងវិទ្យាសាស្ត្រ ជាមួយនឹងទ្រឹស្ដីបទចំណុចថេរ Banach ដែលបានអនុវត្តន៍ ដូច្នេះវាដាច់ស្រឡះពីទម្រង់ដើមរបស់វា ។
ឯកសារយោងៈ
[E] M. Eisermann, Comment Google classe les pages webb, http://images.math.cnrs.fr/Comment-Google-classe-les-pages.html, 2009.
[LM] A. N. Langville and C. D. Meyer, A Survey of Eigenvector Nethods for Web Information Retrieval, SIAM Review, Volume 47, Issue 1, (2005), pp. 135-161.
[RS] C. Rousseau and Y. Saint-Aubin, Mathematics and technology, SUMAT Series, Springer-Verlag, 2008 (A French version of the book exists, published in the same series).
របៀបដែល Google ធ្វើការ: ខ្សែសង្វាក់ Markov និង eigenvalues (PDF)